02 / 07 · Rust · CUDA · NVRTC
synaptix
Нативный движок на Rust для запуска и обучения нейросетей — написанные вручную CUDA-ядра, которые компилируются на лету через NVRTC. Без PyTorch, без libtorch и без Python.
- Лицензия
- MIT OR Apache-2.0
- Платформа
- CUDA sm_80+ · запасной путь на CPU
- Пакеты
- Cargo, из исходников
- Статус
- Молодой, API нестабилен
Что это
Альтернатива Python-стеку для машинного обучения. Всё — от API тензоров и CUDA-ядер до полных портов моделей, токенизатора, движка инференса со страничным KV-кэшем и стека обучения — написано на Rust.
Работает на любой видеокарте NVIDIA от sm_80 (Ampere): ядра компилируются на лету под конкретную карту, на Blackwell есть родные тензорные пути NVFP4 / MXFP8, на остальных — переносимые ядра. Модели загружаются из однофайловых бандлов .syn или прямо из GGUF. Корректность проверяется побитовым совпадением с эталонами PyTorch и NeMo — построчно, а не по общему косинусному сходству, за которым прячутся локальные ошибки.
Возможности
- CUDA-ядра, написанные вручную и компилируемые через NVRTC под compute capability конкретной карты; любая карта от sm_80, родной block-scale mma.sync на Blackwell (sm_120+).
- Порты моделей, сверенные с оригиналами: Qwen3 (плотные и MoE), гибриды Qwen3-Next, Qwen4Exp на 125B MoE, Llama, Gemma-3, Gemma-4, Muse Glimmer; FLUX.1, FLUX.2, Qwen-Image 2.1, Qwen-Image-Edit, SDXL; видео LTX-2.3 и MiniMax-H3.
- Речь и музыка: Whisper, GigaAM, Sortformer; VoxCPM, OmniVoice, VibeVoice, Audio8-TTS, Supertonic 3, Leokani-tts 7M, F5-TTS Russian, Silero TTS v5; YuE2, SheetSage2, ACE-Step; эмбеддинги BGE-M3 и реранкер.
- Silero TTS v5 — все 12 пакетов, перенесены целиком без Python и TorchScript: сеть (длительности, высота тона, FastPitch-подобная акустическая модель с «песочными часами», вокодер Vocos 48 кГц, PQMF для 24 / 8 кГц) и текстовый фронтенд. Во всех пакетах ударения и «ё» для русского ставятся автоматически (пакеты СНГ используют для русских голосов расстановщик из v5_6), омографы решает BERT, числа читаются словами, а английские слова латиницей — по английскому произношению (iPhone → «айф+оун»); интонация вопросов; пакеты СНГ на 20+ языков, в том числе казахский, татарский, башкирский, украинский и узбекский. Последовательности символов и длительности совпадают с оригиналом бит в бит, ударения и омографы — 290 из 290 строк; RTF ≈ 0,01 на процессоре ПК (~23 млн параметров). Лицензии: v5_cis_base / _nostress — MIT, остальные — CC BY-NC 4.0.
- F5-TTS Russian — все 8 версий Misha24-10/F5-TTS_RUSSIAN (веса под CC BY-NC 4.0): клонирование голоса по записи до 12 с и её тексту, русский и английский, ударение знаком «+» перед гласной, длинный текст кусками с плавными стыками; совпадает с оригиналом на PyTorch (мел 4e-5, вокодер 2e-5), RTF ≈ 0,1–0,17 на RTX, работает и на процессоре.
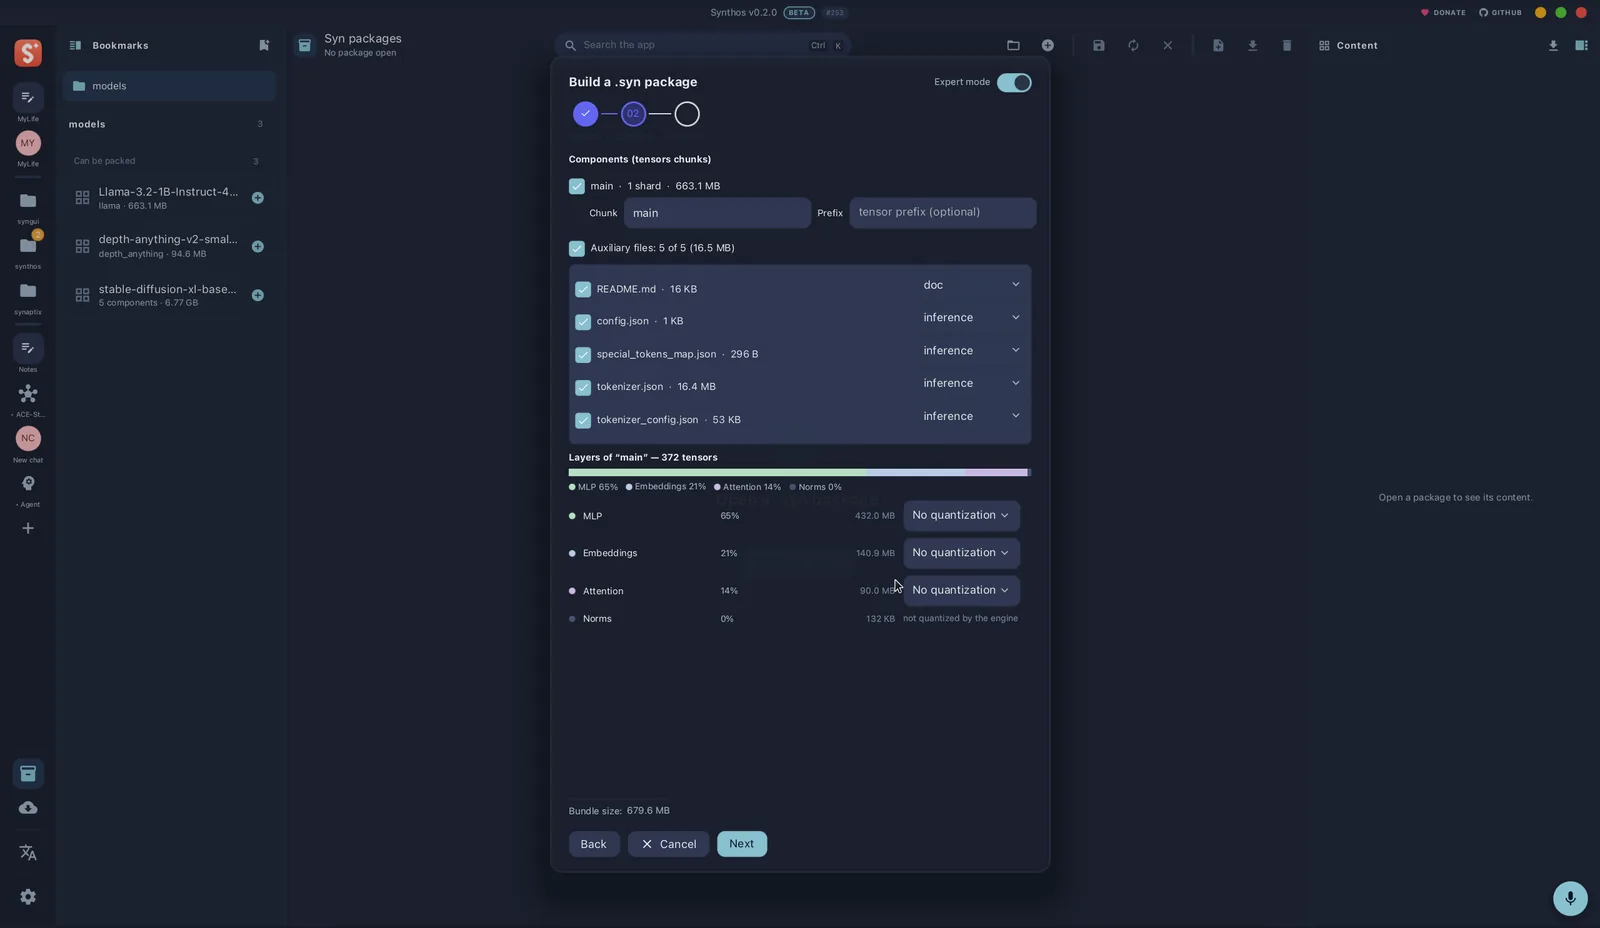
- Однофайловые бандлы .syn: читаются через mmap без копирования, квантуются при упаковке, точность выбирается для каждой группы слоёв.
- SQ1…SQ8 — переносимый блочный формат с энкодером на GPU; GGUF работает напрямую со всеми 27 типами блоков ggml; квантованный бандл можно перекодировать при загрузке под старую карту.
- KV-кэш в MXFP8 по умолчанию, страничный KV, декод через CUDA-граф и спекулятивное декодирование.
- Эксперты MoE живут в закреплённой памяти хоста и подкачиваются со скоростью ~39 ГБ/с, плюс частичная выгрузка блоков: MoE на 125B работает на карте 24 ГБ, а все семейства моделей проверены на 7 ГБ.
- Сессии префикс-KV переживают смену хода у всех архитектур, включая промпты с картинками.
- CLI на всё: inspect, convert, quantize, run, chat, bench, imagine, video, music, speak, podcast, transcribe.
Замеры скорости
| Модель | Префилл | Декод | Примечание |
|---|---|---|---|
| Gemma-4 26B A4B | 10 100 tok/s @ 4k | 210 tok/s | CUDA-graph decode captures the MoE |
| Qwen3.8-27B hybrid | 1 450 tok/s @ 3.3k | 47 tok/s | MTP speculative decode |
| Qwen3.8-Flash-Next 125B MoE | 1 650 tok/s @ 260k | 36 tok/s (4-bit) · 48 tok/s (3-bit) | experts in RAM, 262k context on 24 GB |
Декод Gemma-4 вырос с 35 до 210 ток/с, а префилл — с 957 до 10 100 ток/с за неделю работы над ядрами. Диффузия 1024²: SDXL за 30 шагов — 6,5 с (пик 8,8 ГБ), Qwen-Image-Edit-2511 за 40 шагов — 155 с в NVFP4 (пик 13,2 ГБ).
Замерено на ноутбучной RTX 5090 (24 ГБ) с 93 ГБ оперативной памяти, Arch Linux.
Установка
cargo build --release -p synaptix-cli
synaptix convert model.gguf model.syn
synaptix run model.gguf "Explain NVFP4" --max-tokens 256
synaptix bench model.syn --n-tokens 128
Для сборки нужен CUDA toolkit (по nvcc фиксируется версия CUDA); драйвер подгружается динамически при запуске. Эталонные тензоры для побитовых тестов в репозиторий не входят — их генерируют скрипты из scripts/reference/.
Требования и ограничения
- CUDA (основной путь) и CPU. Любая карта от sm_80; родной block-scale MMA для NVFP4 / MXFP8 требует Blackwell (sm_120+), на старых картах те же веса идут через ядра с деквантованием.
- Проект молодой, автор один: API нестабилен, ломающие изменения будут.
- Готов к работе инференс — на нём каждый день работает synthos. В обучении есть рабочий autograd, оптимизаторы и чекпойнты, но модули RLHF, дистилляции и self-play — пока каркас.
- Часть каталогов моделей — заглушки; реально работают только модели из списка в README.
- Слабые места описаны, а не спрятаны: bf16 GEMM даёт 0,82–1,16× от cuBLAS в зависимости от формы и отстаёт на больших M.
Скриншоты
- (открыть в полном размере)
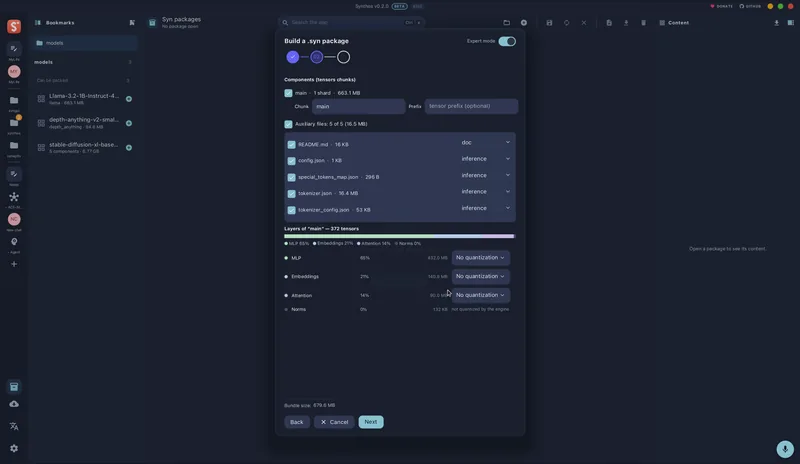
Упаковка бандла .syn: компоненты, вспомогательные файлы и точность для каждой группы слоёв (интерфейс synthos) - (открыть в полном размере)
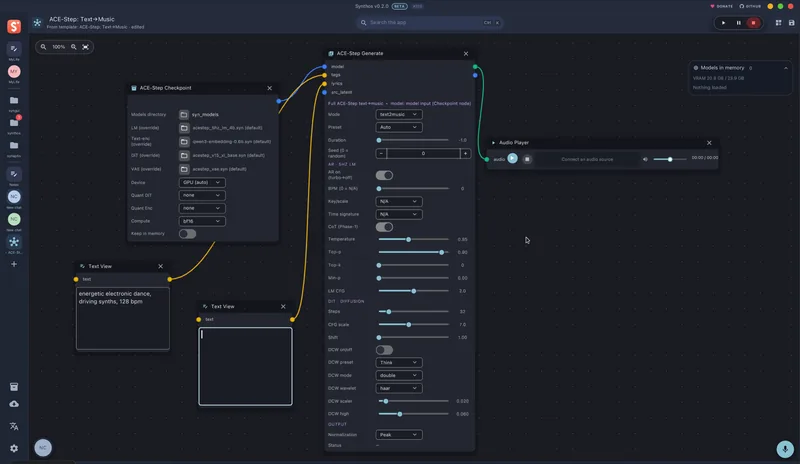
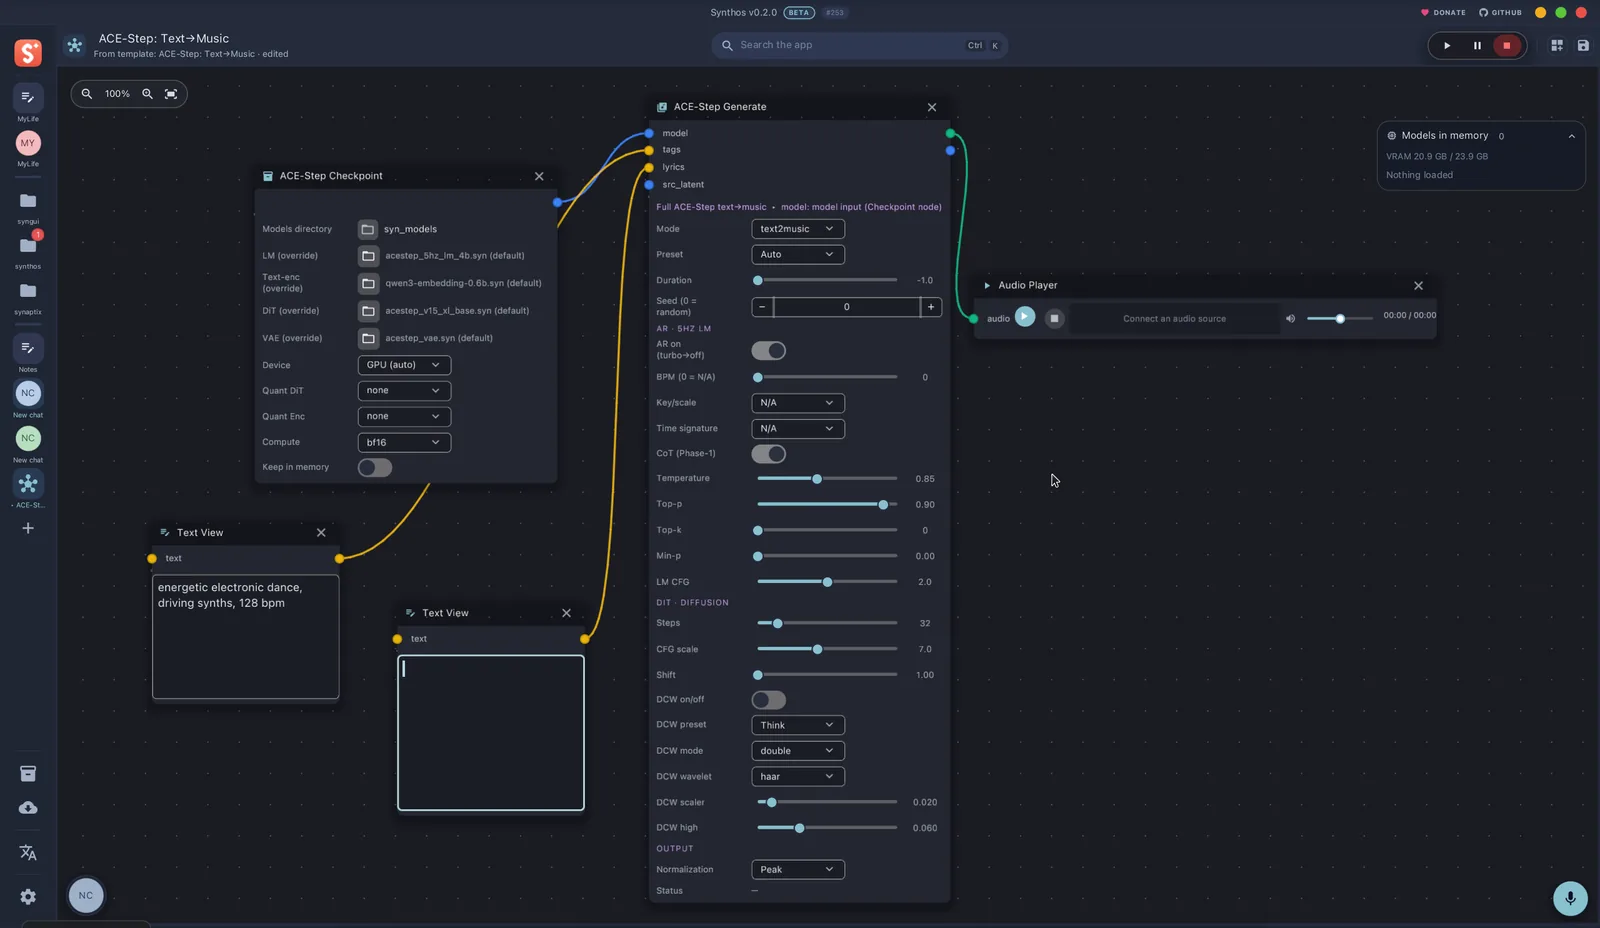
Граф ACE-Step «текст → музыка» на synaptix (нодовый редактор synthos) - (открыть в полном размере)
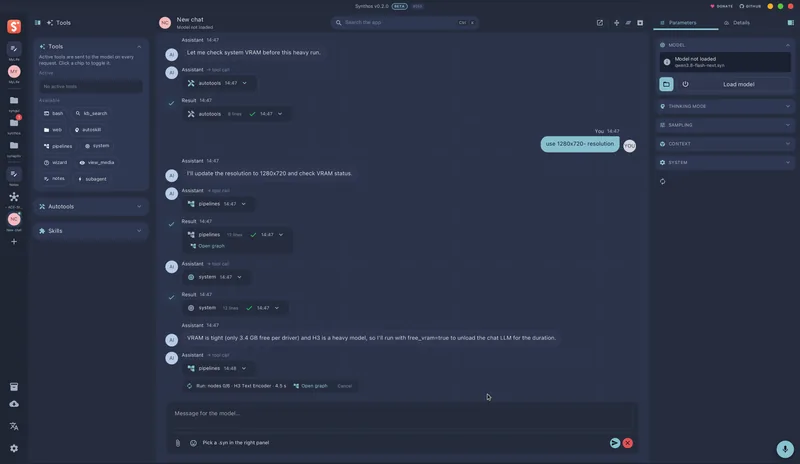
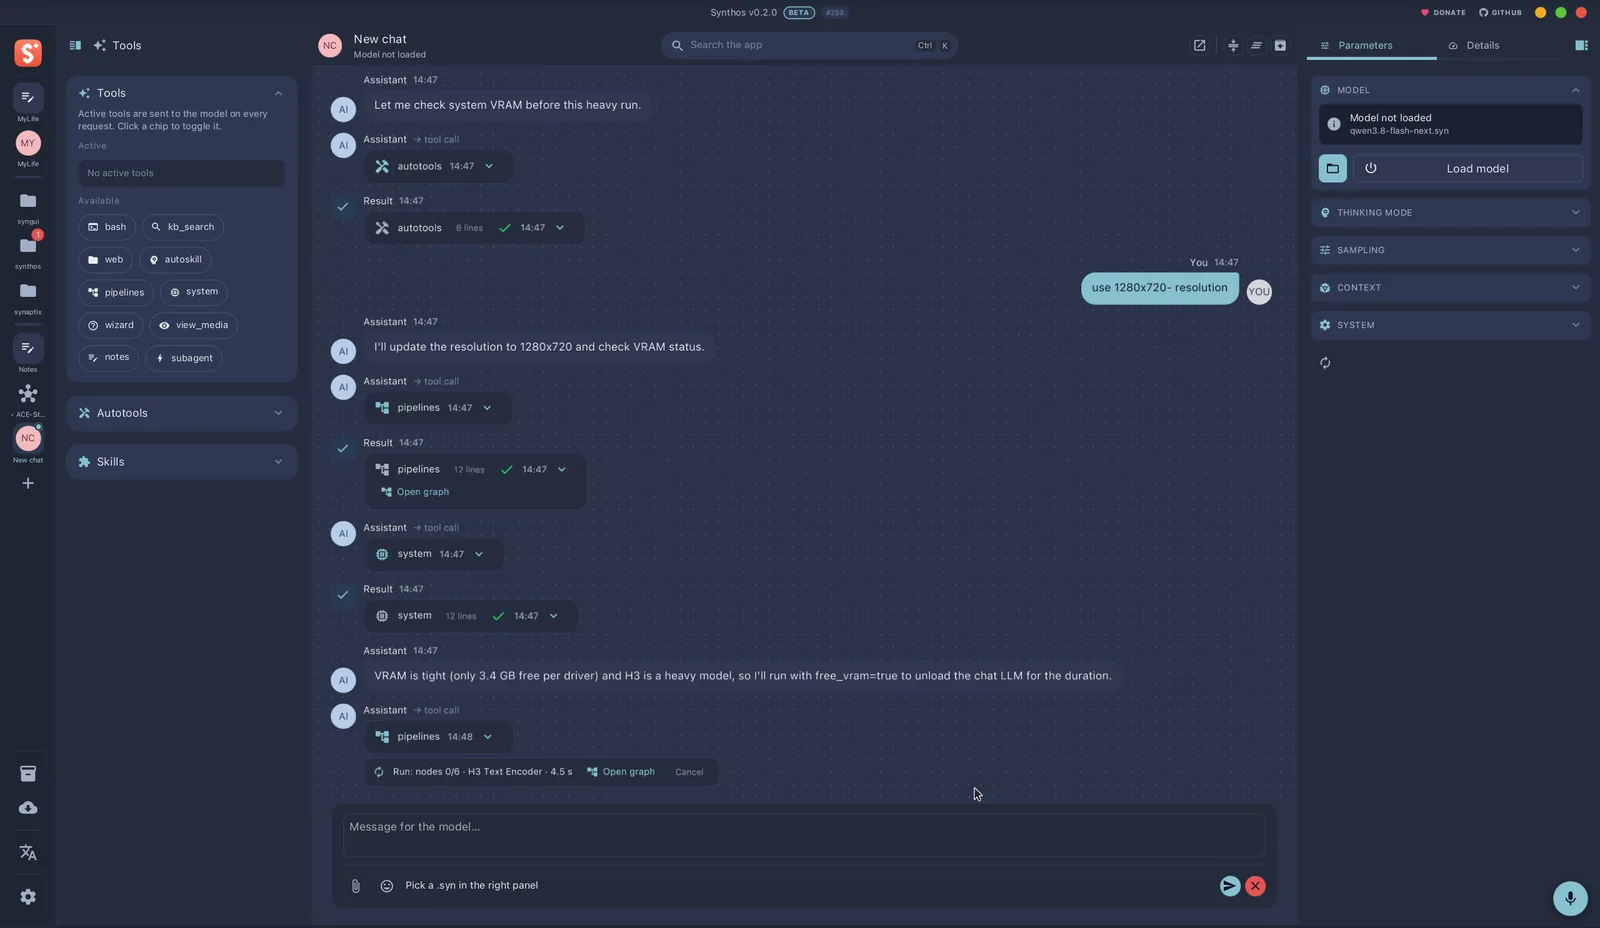
Агент проверяет видеопамять, освобождает её и запускает генерацию видео (synthos)
Замерено, а не обещано
Как проверено
Каждая цифра в README измерена на моей машине, а корректность проверяется по эталонным реализациям слой за слоем, а не принимается на веру.
Каждая цифра здесь измерена на моём железе. github.com/VitaminDB/synaptix